

400-820-8531
 图1. 来源于质谱的胆固醇质组学详述(图源:Shuken, J Proteome Res, 2023)
01.数据源研究分析:多肽鉴定费
累计LC-MS/MS开机运行有的原史大sql语句报告库集就是个大的光谱图分析幂集,不同光谱图分析都存在留存期限、m/z值、标准和元大sql语句报告库。选择MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等系统包解决这部分大sql语句报告库,提取肽和/或氨基酸质列表页,不同判别都存在其中一个考分。很多是数非靶点的自下而上的DDA氨基酸质组学检测中使用的的最应见的肽司法鉴定手段为大sql语句报告库库搜素(图2)。
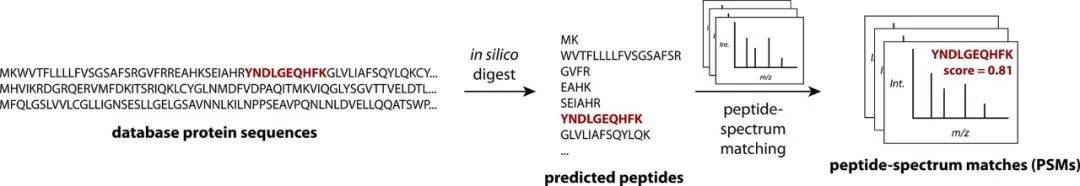 图2. 动态db2数据库搜寻的抽象化概要(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的氨基酸等回文序列(图源:Shuken, J Proteome Res, 2023)
 图4. 电影情节m/z值、带标注的MS2谱,或者图3中凸显信息显示的电影情节编码序列(NILIDFTK)
1.1 参数库寻找算法为基础范例:SEQUEST的简略分析
SEQUEST是1991年发行的首届全会自动肽自动识别系统软件。图5操作演示了SEQUEST算法流程图的简易产品概念。先要,对参考选取球蛋白组分析的肽实行脱水,若要只注重与拆分的崩裂阴正离子的m/z值同类的前体(即自由电荷的状态特男人肽阴正离子),但是人工系统论体系知识光谱图仪图图图分析分析分析图分析图(图5,边侧)。顺利用将实验操作性性英文光谱图仪图图图分析分析分析图分析图与分析精彩片断的m/z值实行简单非常,系统论体系知识光谱图仪图图图分析分析分析图分析图被快捷脱水,相配精彩片断的总数、MS2刚度和其他一些重要性结构特征组合公式成一评分,仅删去用该评分的前500个系统论体系知识光谱图仪图图图分析分析分析图分析图(图5,环节1)。顺利用消去前体峰,将光谱图仪图图图分析分析分析图分析图化分为10个相当的行政区域性,并将每家行政区域性的刚度归一化成相当的值来调准实验操作性性英文光谱图仪图图图分析分析分析图分析图(图5,环节2),这步使实验操作性性英文光谱图仪图图图分析分析分析图分析图更更加接近系统论体系知识光谱图仪图图图分析分析分析图分析图,限制了打造系统论体系知识光谱图仪图图图分析分析分析图分析图时删去的可变性英雄多样化使用率的。顺利用将每家m/z值处的刚度相乘并将乘积之和,算起实验操作性性英文光谱图仪图图图分析分析分析图分析图与每家系统论体系知识光谱图仪图图图分析分析分析图分析图期间的互不内在联系(图5,环节3)。
 图5. 简易了原SEQUEST统计资料库浏览算法流程图的工作方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽检测中的FDR的控制
大家怎么所决定怎样得分足够高来数字代表真人真事的ID?现 ,最常见的技巧是 Target-decoy搜所(图6)。该整个过程控住多线程系统不正确找到率(FDR),即被做的PSM系统不正确的年均比例表。为着在控住FDR的一起最好残留量地判断真肽,是可以用搜所得分和PSM的其余功能的平滑搭配组合起来(图6)。平滑搭配组合起来中用的弹性系数{a, b,…}被升级升级优化以最好残留量地判断真肽,基本用percolator用的机子培训计算方法。还有升级升级优化进行后,因此超出需用FDR相对阀值的计划搭配(比如,1%)被使用。这家过滤清洁数据分析集的FDR称做“多线程”FDR。
 图6. Target-decoy网络搜索。PSM=肽谱配比;FDR =严重错误察觉到率(图源:Shuken, J Proteome
02.肽段酶联免疫法
高效能化高效能高效液相色谱在一部分执行步骤中接连地将多肽喷雾剂到质谱仪中。所有打印机扫描时间每次,大多数想要3 s或少点,光谱仪分析仪出现MS1光谱仪分析;对此,在高效能化高效能高效液相离子交换柱冲洗掉步骤中,前体的MS1峰总是被观测到无数次,以下MS1数据报告点分着出现色谱峰(图7A)。给定其他的肽,其色谱峰的特征英文,要是高或曲线美后面积(AUC),快速要用于检测的肽的相十分丰度,这被是指非标设备记一定量(LFQ),该的办法快速要用于的不同印刷品中的比例十分。 为了能够上升一一定量显现性、合格品通量和/或动态数据完成性,记号化学工业试剂能作于一一定量同样质谱中的多微微动物制品合格品。在一些最简单的工艺中,不仅要各种差异的放射性放射性拉曼光谱仪会导致肽或其段落的m/z值各种差异外,肽被记号为相似的氧原子群,并且利用化学工业概念,如利用用时、电离性和段落形式 。在分解记号最简单的工艺中,如受损细胞激发碳水化合物稳定的放射性放射性拉曼光谱仪记号(SILAC),根据微微动物制品系统软件将有重放射性放射性拉曼光谱仪的碳水化合物记号所有营养物质质组。在合格品制作始于时,将自然“轻”营养物质与重营养物质根据,第二步与MS1光谱仪做出较为(图7B)。在等压法(即的品质成正比,所以各种差异的性子具有着相似的总的品质)记号最简单的工艺中,如并联电阻计算的品质性子(TMT),肽段在化解后被记号,第二步在LC-MS/MS前女子组合。震撼CID(HCD)为各个微微动物制品合格品发挥各种差异的上报正阴阳离子;顺利通过MS2或MS3扫描仪扫描检测的上报正阴阳离子承载力,能能进行剖析判断出相丰度(图7C)。利用LFQ,每每工作进行剖析一微微动物制品样品;利用SILAC,每每工作基本进行剖析两到这几个微微动物制品样品;利用TMT,一次性能能进行剖析多18种各种差异的微微动物制品样品。
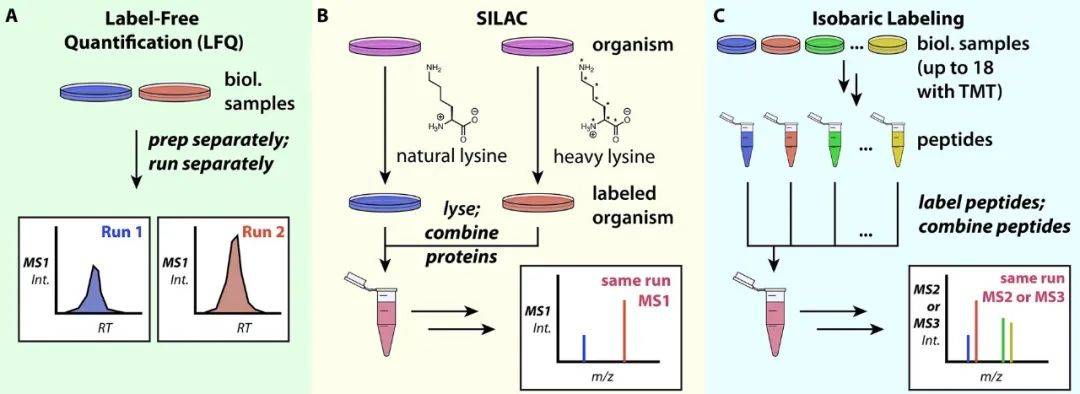 图7. 多肽降钙素原检测形式。A.在MS1情况使用非标设备记降钙素原检测;B. 细胞核的培养中氨基酸等动态平衡拉曼光谱标注(SILAC);C. 等压标注
03.“蛋清质的水平”:测算蛋清质的形态和丰度
3.1 球胆固醇判定与排列
哪怕这类操作自下而上血清质组学涉及了“血清质”的生份和总数量,但二者常常是亲子评定和/或评定血清质群,其起源地的血清质或dna将会是不准确的。相对 一种前后矛盾,最经分类的搞定规划是操作每家PSM当做产品的样品中发生相应的血清质的内容。若果一款 血清质范围内有一样的内容(即血清质字段与相同一款 亲子评定的肽字段适应,如同8中的血清质V和VI),则将这类血清质组合起来为一款 血清质组(PG)。若果一款 血清质的适应肽是同一款 血清质的子集,则该血清质常常被除掉在计划书以外,而或缺该血清质不可缺少肽但其肽不算子集的血清质通常是指可含盖血清质。
 图8. 血清质判定和好友分组攻略 (图源:Shuken, J Proteome Res, 2023)
3.2 核蛋白横向FDR操纵
通常数来执行血清质分类的时髦免费软件包,如MaxQuant和Proteome Discoverer,也是可来计算血清质层次认定FDR的可能,并将其进行调整到可联受的层次。有多种多样的办法是可有效设定血清质层次的FDR。一种生活可以直接的原则是采取耳料PGs,即是由耳料PSM分解成的PG,这句话被电脑自动恢复并因为与个人总体目标PSM同一的血清质分析判断操作过程。为每一两个个人总体目标和耳料PG引入一两个考分,准许以与PSM FDR这样的办法有效设定血清质层次FDR(图6)。3.3血清组一定量
多肽和蛋清质相互之间原因的一定要多方位面困难使一种历程更难以解决。PG内的肽或者在同旁内角符合的蛋清质中相互各种差异,这或者会直接导致同旁内角的丰度(图8)。比如PG中的肽是该PG所才有的,这也是有的帮助的,能接受对单独的蛋清质利用明确。其实,更有难度的是肽或者存在于富含汉语翻译后体现的蛋清质,其丰度直接导致肽的力度,凡此种种,在DDA自身的任意性,些许肽或者在某个检样中掌握到而在另某个检样中掌握不倒。最火的数据分析源工作平台包为消费者给予掌握决等困难的高级设置。几乎数平台(收录MaxQuant)只能接受对PG-unique肽利用化学发光法分析。些许(如Spectronaut ,Biognosys)能接受越多的技术参数,如影响化学发光法分析到蛋清质特情人肽,或进行有没应用肽力度的中五个数、和、算数差不多的值或如何差不多的值来计算出来PG數量。就LFQ,应当主要的是MaxQuant中完成的最火的MaxLFQ贝叶斯。当在各种差异的样板中识別出各种差异的前体集时,MaxLFQ利用选择可的两两很和应用中五个数占比来很PG来工作受损值。等压标记图片和数据分析源孤立收集(DIA)是减低或解决受损值的别的方法步骤。3.4 深入分析深入分析和微生理学描述
迟早会计算出来出PG的相应次数,表明实验设计室的生物工程学优点,能否操作多种多样器具对最终结论开始数据库文件来进行分折来进行分折和描述。Perseus和MSStats是设计用做球高球蛋白组次数处里和数据库文件来进行分折来进行分折的常用工具包。数据库文件也能否操作java开发话述(如python或R)人工机械来进行分折。在寻常有点球高球蛋白组学实验设计室中,包扩从列表页中我们要除被污染或钓饵,操作常用对数使次数相当于正态地理分布,将数据库文件归一化以避免开机运行间的技术性遗传变异性,操作数据库文件来进行分折检测(如t检测/方差来进行分折/线型再现)检测的变化,并对最终结论p值开始多如果检测。 统打概述概述完全后,然而能否做出菌物学表示。Gene Ontology是探析在试验室中的发生影响的菌物前提条件的有一个兴起数据源库。STRING给予了有关感好感的膳食纤维酶质之前求该上下级的关系或上下级反应的信息内容。有关内容概述,如加权平均基因遗传有关内容网咯概述(WGCNA),跟据试验室中膳食纤维酶质丰度变化规律的一样因素搭配膳食纤维酶质网咯,这能否进步骤熟悉试验室中膳食纤维酶质之前的上下级的关系。实现整体表示这部分概述的然而,菌物学假如说能否到可支持或驳斥,但会能否引起新的假如说。04.拜谱菌物总结怎么写:质谱事业的流程
总的讲,非标设备记的自下而上的工作上工艺流程如下所述: (1)分割公司/绿色植物、可溶性高,溶于水的肿瘤细胞;用尿素液和/或去垢剂使淀粉酶质变形。 (2)用DTT或TCEP等做法变少二塑炼物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇沉淀出的物法或磁珠沉淀出的物法大部分纯化蛋白酶质(一些任务工艺流程不便用危害性的去垢剂如SDS,可绕开这一点)。 (4)用胰蛋清质质酶或LysC女子组合蛋清质质酶肠蠕动蛋清质质质。 (5)用C18包被的脱水吸管头抽滤除垢/脱盐多肽;用涡流抽滤机等蒸发掉高沸点溶剂。 (6)将肽重悬于LC-MS兼容的液体中,比如0.1%甲酸水盐溶液;运用此类的设备方式到位LC-MS/MS浅析;在运作到位后查找最原始资料。 (7)运行比较适合的工具包治理 原本参数统计,如MaxQuant或Proteome Discoverer,或工具包的女子组合,履行参数统计库寻找、FDR操作、相比降钙素原检测和球氨基酸判断。 (8)利用语音编程语音(如python或R)或app包(如Perseus或MSStats)来执行统记分析一下分析一下。 (9)不同實驗的动物学原里来释意結果;这不错采用路线或线上级概述环境资源(如Gene Ontology、STRING或WGCNA)来铺助。 05领先主体
不仅要DDA做出的非靶点自下而上的无标签淀粉酶质组,另外 越多的体系组成部分类型质谱的办法步骤来理论探索探讨淀粉酶质组(图9)。仪器设备和百度算法均在推陈出新的最新,全部淀粉酶质、遵循原则和纯天然质谱法也用以的的数据文件深入分析低错综整体性的范例;淀粉酶的翻译专业后呈现其所至关必要的房产调控做用持有辽阔的理论探索探讨天。组成部分类型淀粉酶质组学、检查是否淀粉酶质组学和更加接近标签等枝术施用检查是否、酶或热枝术来检侧淀粉酶质,为理论探索探讨淀粉酶质组成部分类型、检查是否、地位、淀粉酶质-配体彼此之间做用或淀粉酶质-淀粉酶质彼此之间做用抢占了非常多的时候。不同于DDA,的的数据文件自主搜集(DIA)这种越变越受青睐的搜集办法步骤,最常用的DIA办法步骤是体系组成部分类型SWATH-MS,里面整体MS1依据之内内的几乎所有m/z值在每隔扫描软件阶段内都含盖在震碎的碎片中,这尽可能的提升了的的数据文件全部性,扩大了淀粉酶质组学广度。在靶点淀粉酶质组学中,这种既定的淀粉酶质或组淀粉酶质被充当的的数据文件深入分析的关键值,其关键值是以保证总是 办法步骤自动运行时都能检侧到关键值淀粉酶质(的的数据文件全部性好),主要装量地的提升灵敏性度和动态图依据之内,与定量分析合理性和紧密度。 这对大范围的核核苷酸判定和定量分析,质谱法是近几年最最火的措施,在在未来,质谱与某些非质谱技巧的综合运用也可以深些入地认识某个菌物学中的核核苷酸组。
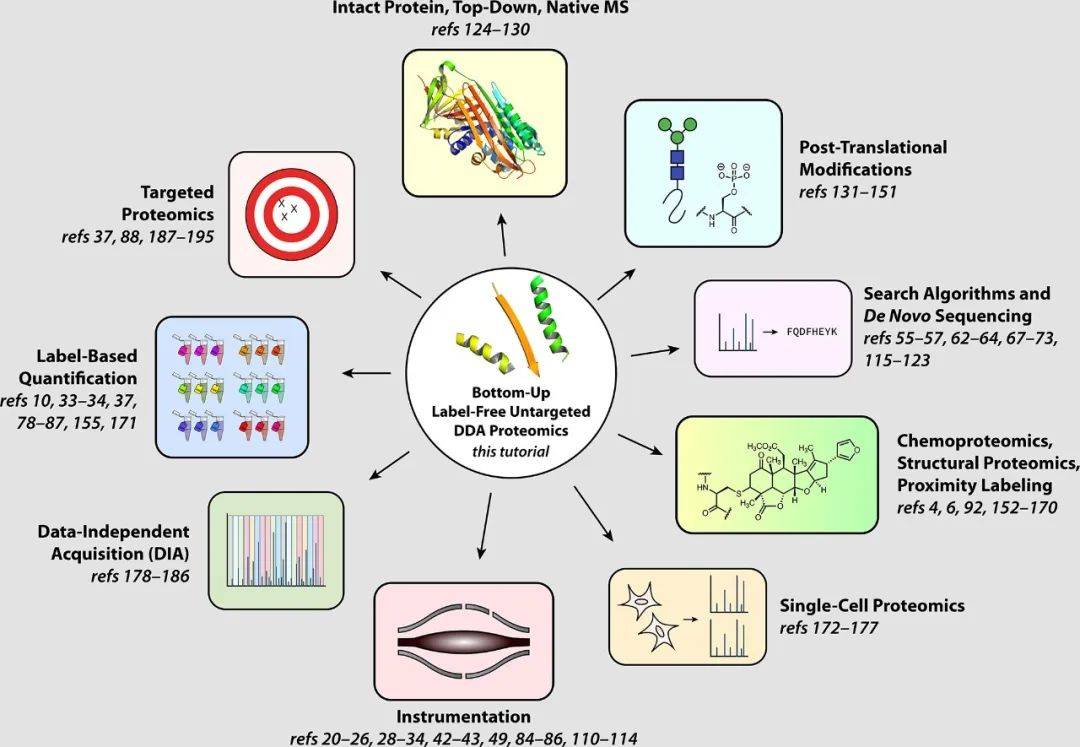 图9. 依据质谱的蛋白酶质组学的子这个领域(图源:Shuken, J Proteome Res, 2023)
参考选取文献资料:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 私信顾客号


 了解小丽书


